La mayoría de los equipos de ciencia de datos aprenden por las malas que un notebook funcional y un sistema de ML en producción no son lo mismo. El modelo corre. Los resultados parecen buenos. Luego alguien pide desplegarlo, reentrenarlo según un calendario, auditar sus datos de entrenamiento o ejecutarlo en tres entornos a la vez, y la infraestructura que nunca fue diseñada de verdad colapsa bajo el peso de requisitos para los que nunca fue construida. El entrenamiento representa aproximadamente el 15% del esfuerzo en un sistema de ML en producción; el resto es infraestructura, gobernanza, monitorización y la fontanería que lo mantiene todo unido.
Definir bien la arquitectura de la plataforma de ciencia de datos desde el principio implica tomar decisiones deliberadas sobre paridad de entornos, residencia de datos, reproducibilidad y los servicios gestionados que absorben la carga operativa que tu equipo no debería estar asumiendo. Este artículo explica cómo estructurar esa plataforma y dónde las decisiones que parecen pequeñas al principio se vuelven costosas más adelante.
La brecha entre el notebook y la producción es un problema de infraestructura
La mayoría de los debates sobre ML se centran en la calidad del modelo. El problema más difícil es que un modelo entrenado en el entorno local de un científico de datos, sobre un snapshot de datos, con versiones de librerías que nadie documentó, no puede reproducirse de forma fiable seis meses después. No puede auditarse. No puede promoverse de forma segura a través de dev, staging y producción sin que alguien recree manualmente unas condiciones que nunca se capturaron formalmente.
La solución es tratar todo el flujo de trabajo de ML como un pipeline definido como código. Herramientas de infraestructura como código, como Terraform, definen y gestionan los entornos de forma programática, de modo que dev, staging y producción no sean aproximaciones entre sí, sino configuraciones demostrablemente idénticas, versionadas junto al propio código del modelo. Cada dependencia, cada control de acceso, cada definición de tabla externa vive en un repositorio. La deriva se vuelve detectable en lugar de invisible.
La separación de responsabilidades importa tanto como el control de versiones. Las capas de preparación de datos, almacenamiento, interfaces de acceso y consumo deben estar claramente delimitadas para que un cambio en una capa no rompa silenciosamente otra. En una plataforma bien estructurada, los datos fluyen de forma unidireccional desde las fuentes de origen, pasando por la preparación y el almacenamiento, hasta el consumo final. Ese contrato unidireccional es lo que hace que el sistema sea testeable y que el impacto de los cambios sea local en lugar de global.
La complejidad de los entornos múltiples es real y se subestima
El salto de un único entorno a una configuración multi-etapa gobernada es donde la mayoría de los equipos se topan con su primer muro serio de infraestructura. Dev, staging y producción necesitan compartir suficiente estructura para que la promoción tenga sentido, pero diferenciarse lo suficiente para proteger los datos de producción y controlar los costes. Mantener una gobernanza de datos coherente en los tres entornos, mientras se gestiona además la superficie operativa de los servicios que los sustentan, supone una carga continua considerable.
La elección del patrón de entrenamiento condiciona todo lo que viene después: la huella de cómputo, el perfil de costes, los componentes de monitorización y los runbooks de incidencias. Un proyecto optimizado para reentrenamiento trimestral tendrá una infraestructura diferente a uno diseñado para actualizaciones del modelo cada hora.
Los servicios gestionados para bases de datos, colas de mensajes, almacenamiento de objetos y procesamiento de datos reducen esa carga de forma sustancial. Cuando el parcheo de la base de datos, el escalado de Redis y la replicación del almacenamiento de objetos se gestionan a nivel de plataforma, tu equipo dedica su tiempo a la lógica del modelo y al diseño de pipelines, en lugar de a un mantenimiento operativo que no aporta ningún valor científico. La clave está en elegir servicios gestionados que estén genuinamente integrados, no una colección de herramientas de terceros acopladas de forma laxa que cada una introduce sus propios modos de fallo y modelos de control de acceso.
Los pipelines de CI/CD para ML no son opcionales en una configuración multi-entorno. La promoción de modelos debe estar controlada: un modelo pasa de dev a staging solo después de que las pruebas automatizadas superen un dataset definido; pasa a producción solo después de que la validación en staging lo apruebe. El control de versiones abarca no solo el código, sino también los artefactos del modelo, las versiones de los datasets y los esquemas de metadatos que los describen. Sin esa disciplina, el rastro de auditoría que los reguladores y los equipos de gobernanza interna acabarán solicitando simplemente no existe.
Residencia de datos y soberanía no son el mismo contrato
Los equipos europeos de ciencia de datos que trabajan con datos personales, historiales clínicos o datos financieros regulados necesitan entender una distinción que el marketing de la mayoría de los proveedores cloud tiende a difuminar: la residencia de datos indica dónde se almacenan los datos; la soberanía de datos determina quién controla el acceso a ellos y bajo qué jurisdicción legal.
Un modelo entrenado con datos personales en un centro de datos de Frankfurt operado por un proveedor cloud con sede en Estados Unidos cumple los requisitos de residencia geográfica. No cumple los de soberanía, porque ese proveedor sigue sujeto a la legislación extraterritorial estadounidense. La sentencia Schrems II del TJUE dejó claro que los responsables del tratamiento que utilizan Cláusulas Contractuales Tipo deben evaluar si el marco legal del país de destino ofrece una protección esencialmente equivalente a la del RGPD. Una cláusula contractual no puede anular una ley que obliga a la divulgación.
El Reglamento de IA de la UE añade otra capa. Los sistemas de IA de alto riesgo deben cumplir el artículo 10, que exige que los datasets de entrenamiento, validación y prueba sean pertinentes, suficientemente representativos y estén libres de errores en la medida de lo posible, con una gobernanza de datos documentada que cubra la recopilación, el origen, la preparación, el etiquetado y el aseguramiento de la calidad. El seguimiento completo del linaje de datos no es algo deseable; es un requisito exigible para los sistemas clasificados como de alto riesgo, con plena aplicación a partir de agosto de 2026.
Operamos sobre infraestructura Tier III, carrier-neutral, certificada según ISO 27001, con un SLA contractual del 99,9% de disponibilidad y la residencia de datos garantizada a nivel contractual, no como una opción de configuración que un ticket de soporte puede modificar. La soberanía, en nuestro caso, es un hecho arquitectónico: la infraestructura es europea, la jurisdicción legal es europea y las obligaciones se rigen por el derecho europeo.
Cómo estructurar la plataforma: capas prácticas
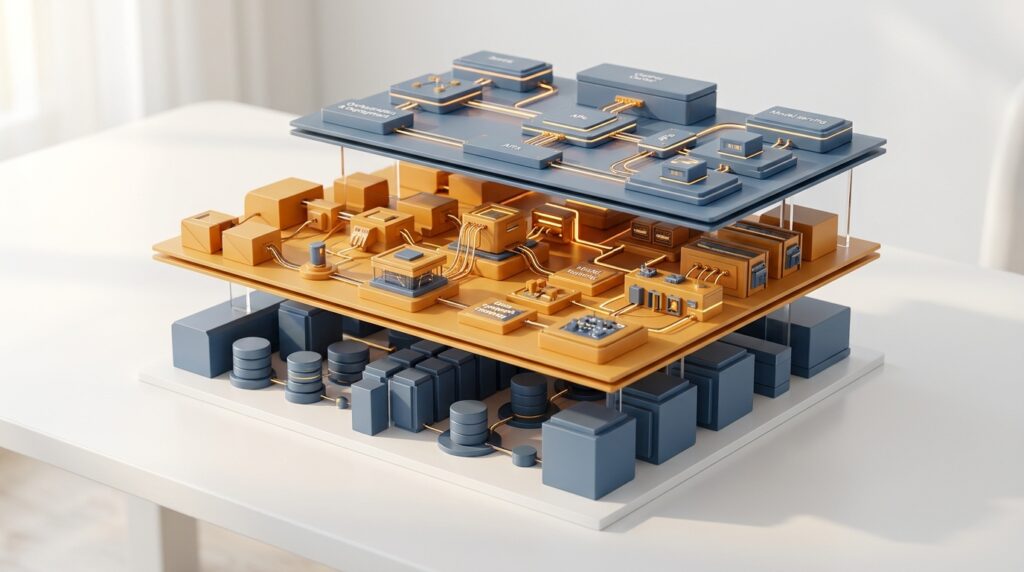
Una plataforma de ciencia de datos reproducible y multi-entorno debe concebirse en capas, cada una con un responsable claro y una interfaz bien definida con las capas adyacentes.
- Capa de cómputo: nodos VPS o bare metal dimensionados según la carga de trabajo, con capacidad GPU disponible para los trabajos de entrenamiento que la requieran. Pools de cómputo separados para dev, staging y producción evitan la contención de recursos y simplifican la atribución de costes.
- Capa de almacenamiento: almacenamiento de objetos para datasets y artefactos de modelos, almacenamiento en bloque para cargas de trabajo de alto rendimiento, con versionado habilitado para que cada ejecución de entrenamiento pueda rastrearse hasta el snapshot exacto del dataset que utilizó.
- Capa de servicios de datos: bases de datos gestionadas para feature stores y registros de metadatos, Redis gestionado para el servicio de características con baja latencia, con controles de acceso definidos en configuración versionada en lugar de aplicados manualmente por entorno.
- Capa de orquestación: definiciones de pipelines como código, con gates de CI/CD que controlan la promoción entre entornos. Las entradas del registro de modelos vinculan los artefactos con las ejecuciones de pipeline y las versiones de datasets que los generaron.
- Capa de observabilidad: monitorización que cubre tanto las métricas de infraestructura como el comportamiento del modelo en producción, con alertas vinculadas a umbrales de deriva y no solo a comprobaciones de salud a nivel de sistema.
Las interfaces entre capas importan tanto como las capas en sí mismas. Una interfaz de almacenamiento bien definida permite cambiar la capa de cómputo sin tocar la de servicios de datos. Un modelo de control de acceso bien definido permite añadir un nuevo entorno sin tener que renegociar permisos en cada servicio.
Dónde se equivocan los equipos
El error más habitual es construir la capa de gobernanza al final, cuando la plataforma ya está en producción. En ese punto, incorporar un registro de modelos a posteriori, añadir el seguimiento del linaje de datos y aplicar la paridad de entornos a una infraestructura ensamblada de forma incremental es un proyecto en sí mismo, a menudo más grande que la construcción original. El segundo error más frecuente es no especificar el patrón de entrenamiento antes de elegir la infraestructura: una plataforma construida para reentrenamiento por lotes mensual necesitará una revisión significativa si el negocio más adelante requiere inferencia diaria con actualizaciones del modelo cada hora.
Empieza por los requisitos de gobernanza. Define cómo es una promoción de modelo antes de construir el primer pipeline. Decide dónde viven los datos, bajo qué jurisdicción y qué debe mostrar el rastro de auditoría antes de ingerir el primer dataset de entrenamiento. Las decisiones de infraestructura que se derivan de esas elecciones son manejables. Las decisiones tomadas en su ausencia son costosas de deshacer.