Un grupo logístico centroeuropeo con unos doce almacenes tenía un caso de uso claro para la visión artificial en logística: contar palés y señalar mercancía dañada en los muelles de carga. El piloto se ejecutó sobre el servicio de IA de un proveedor hiperescalar estadounidense, y la delegada de protección de datos (DPD) lo paró. Las cámaras de los muelles captaban a veces a empleados, y esas imágenes las procesaba un servicio que la DPD no podía evaluar a su satisfacción.
El equipo de operaciones ya había visto el valor. Un daño detectado en el muelle, antes de que se marche el conductor o de que se almacene el palé, zanja una disputa en minutos. Un daño detectado al día siguiente, en un informe por lotes, no zanja nada.
El bloqueo: imágenes de empleados en un servicio de IA estadounidense
El piloto del cliente abarcaba dos almacenes y unas veinte puertas de muelle. Las cámaras enviaban fotogramas al servicio de visión del proveedor hiperescalar, que devolvía detecciones. Los recuentos de palés y las alertas de daños llegaban en una exportación diaria que los supervisores leían a la mañana siguiente.
La objeción de la DPD era concreta. Los fotogramas contenían empleados identificables, el tratamiento corría a cargo de un proveedor estadounidense y la documentación que necesitaba para evaluarlo era una descripción genérica del servicio, no una descripción de este pipeline. Con esa base no iba a aprobar su extensión a doce almacenes.
Lo que el cliente necesitaba de un sustituto
El encargo del cliente incluía cuatro requisitos. Los recogimos en el alcance del proyecto:
- Inferencia en GPU de datacenters de la UE, operados por una empresa sin ninguna matriz por encima a la que pudiera notificarse una orden de un tercer país.
- Un pipeline que la DPD pudiera revisar paso a paso: qué entra, qué se almacena, qué sale y quién puede acceder.
- Alertas de daños entregadas dentro del turno, no en un lote del día siguiente.
- Un coste por fotograma procesado que resistiera el despliegue de dos almacenes a todos.
El último punto importaba más de lo que parece. La estimación del proveedor hiperescalar para doce almacenes había crecido más rápido que el caso de negocio, y finanzas ya se preguntaba si merecía la pena ampliar el proyecto.
Cómo montamos el alojamiento de inferencia de IA en la UE
Construimos y operamos el pipeline sobre nuestros servicios de IA, con GPU en nuestro datacenter de Ámsterdam. Las propias imágenes de muelle del cliente sirvieron para hacer fine-tuning de un modelo de detección de pesos abiertos, que se servía desde un endpoint de inferencia dedicado. Nuestra promesa sobre el entrenamiento es sencilla: tus datos nunca entrenan nada que no sean tus propios modelos.
Los fotogramas viajan desde cada almacén hasta el endpoint cifrados en tránsito, y lo que almacenamos está cifrado en reposo, con las claves gestionadas por nosotros. Solo el personal autorizado de DIVERSITY ubicado en la UE puede acceder a la infraestructura, y el acceso administrativo queda registrado y exige autenticación multifactor. La DPD pudo leer cada una de esas afirmaciones frente a un componente del diagrama.
Tratamiento de las personas que aparecen en la imagen
El pipeline trata a las personas de las imágenes como algo que hay que eliminar, no solo que evitar. Una primera fase detecta personas en cada fotograma y las difumina antes de escribir nada en el almacenamiento. La segunda fase, que cuenta palés y comprueba daños, trabaja sobre el fotograma difuminado.
Solo persisten el recorte de imagen del elemento señalado y sus metadatos (puerta de muelle, marca de tiempo, identificador del palé). Los fotogramas completos se descartan al terminar la inferencia. El cliente eligió ese diseño junto con la DPD, y con él se redujo lo que su revisión tenía que abarcar.
Recuento de palés y detección de daños en el almacén
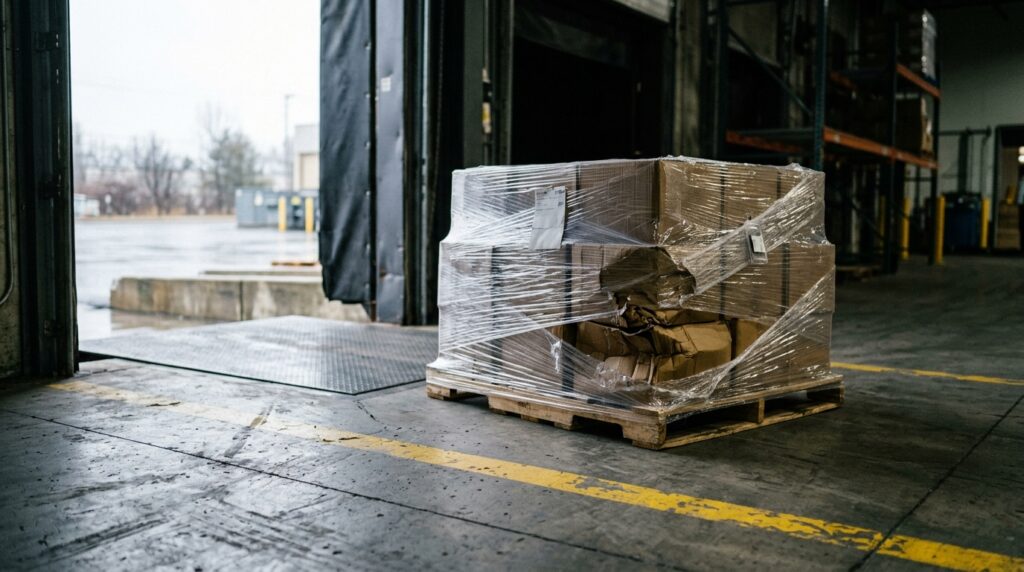
La visión artificial para contar palés parece sencilla hasta que por una puerta de muelle cruza una carretilla, un palé envuelto en film brilla con la luz y hay un remolque a medio descargar. Dedicamos las primeras semanas a las imágenes del propio cliente: turnos de noche, lluvia sobre los burletes de las puertas, tipos de palé mezclados. El modelo de detección aprendió de esas condiciones, no de un conjunto de datos genérico.
La detección de daños trabaja sobre el mismo flujo. El modelo señala esquinas aplastadas, film roto, pilas inclinadas y roturas visibles del producto, y adjunta el recorte para que un supervisor lo confirme en segundos. El equipo de operaciones del cliente comparó los recuentos con conteos manuales durante cuatro semanas en los dos almacenes piloto antes de fiarse de las cifras.
Una alerta de daños que llega cuando el camión ya se ha ido es un registro. Una que llega con el palé todavía en el muelle es una decisión.
Alertas a los supervisores dentro del mismo turno
El sistema anterior agrupaba los resultados por la noche. Lo sustituimos por resultados enviados al dashboard del supervisor de muelle en cuanto se completa cada detección, con el recorte adjunto. Un supervisor puede retener un palé, fotografiar la reclamación para el transportista y registrar la incidencia antes de que entre el siguiente remolque.
La documentación detrás de la revisión de la DPD
La revisión de la DPD del análisis de vídeo en el marco del RGPD era el paso obligado, así que tratamos la documentación como parte del desarrollo. Redactamos el tratamiento tal como se ejecutaba de verdad: categorías de datos, la fase de difuminado, qué persiste, dónde se almacena, quién tiene acceso administrativo y cómo se registra ese acceso. Ella revisó esa descripción frente al tratamiento que cubría y planteó preguntas, y en respuesta cambiamos dos cosas: cómo se etiquetan los recortes señalados y quién, por parte del cliente, puede exportarlos.
No le entregamos una declaración de conformidad, y nadie debería hacerlo. La revisión fue suya, quedó documentada y era específica de este pipeline. Ella aprobó que el piloto siguiera adelante.
Despliegue en todos los almacenes y resultado en costes
Con la revisión documentada, el piloto pasó de dos almacenes a todos: unos doce almacenes y alrededor de cien puertas de muelle. Cada nuevo almacén requirió comprobar la colocación de las cámaras y un breve periodo de ajuste a la iluminación local y a los tipos de palé, no reconstruir el pipeline. Nosotros operamos el endpoint y lo monitorizamos, así que el equipo de TI del cliente no asumió la operación de las GPU.
Los costes de inferencia quedaron aproximadamente un tercio por debajo de la estimación del proveedor hiperescalar para el mismo volumen. El equipo financiero del cliente pudo ver esa cifra antes de aprobar el despliegue, y la diferencia se mantuvo al ir añadiendo almacenes.
Qué cambió para el cliente
- Las alertas de daños llegan a los supervisores de muelle dentro del mismo turno, cuando antes llegaban en un lote del día siguiente.
- Los recuentos de palés se generan en cada muelle sin una persona con un portapapeles.
- La objeción de la DPD se resolvió con una revisión documentada del tratamiento, no abandonando el caso de uso.
- El coste por almacén dejó de ser el motivo para frenar el despliegue.
Ahora el cliente ejecuta análisis de vídeo con GPU en la UE, con un pipeline que su DPD ha leído de principio a fin. Si tienes un proyecto de visión artificial atascado en la revisión de protección de datos, podemos enseñarte cómo fue esa revisión en este caso, con los detalles bajo NDA.