La capa de aislamiento de recursos bajo tus contenedores acaba de cambiar
Los cgroups no son fontanería opcional. Son el mecanismo que hace real la gestión de recursos en contenedores: límites de CPU, fronteras de memoria, contabilidad de I/O. Sin ellos, un contenedor es solo una vista de sistema de archivos aislada sin restricciones de recursos aplicables. El kernel ha soportado dos generaciones de este mecanismo, y Kubernetes ha trazado ahora una línea definitiva entre ambas.
Kubernetes 1.36, publicado el 22 de abril de 2026, eliminó por completo el soporte para cgroup v1. No lo deprecó ni lo desactivó por defecto: lo eliminó. Si tus nodos siguen funcionando en modo cgroup v1 cuando actualices, el kubelet no arrancará. La migración debe realizarse a nivel de nodo, antes de la actualización de Kubernetes, y afecta simultáneamente a los parámetros de GRUB, la configuración del runtime de contenedores y la configuración del kubelet.
Este artículo explica qué cambió arquitectónicamente, cómo fue el calendario de eliminación versión por versión, y qué debe auditar tu equipo antes de tocar una actualización de clúster.
cgroup v1 vs cgroup v2: la diferencia arquitectónica que importa
Los cgroups aparecieron por primera vez en Linux 2.6.24 en 2008, desarrollados por ingenieros de Google para la gestión de recursos a gran escala. El diseño de v1 otorgaba a cada controlador de recursos su propio árbol de jerarquía independiente. Un proceso podía pertenecer a un cgroup llamado web-server para límites de memoria y a un cgroup completamente distinto llamado high-priority para límites de CPU. Parece flexible; en la práctica era una fuente persistente de errores de contabilidad.
El ejemplo más claro: el controlador blkio no tenía visibilidad sobre a qué cgroup de memoria pertenecía un proceso. Cuando el kernel enviaba una página a disco, la I/O se cargaba al cgroup raíz, eludiendo por completo los límites de I/O del contenedor. El cumplimiento de recursos parecía correcto a nivel de controlador y era incorrecto a nivel de sistema.
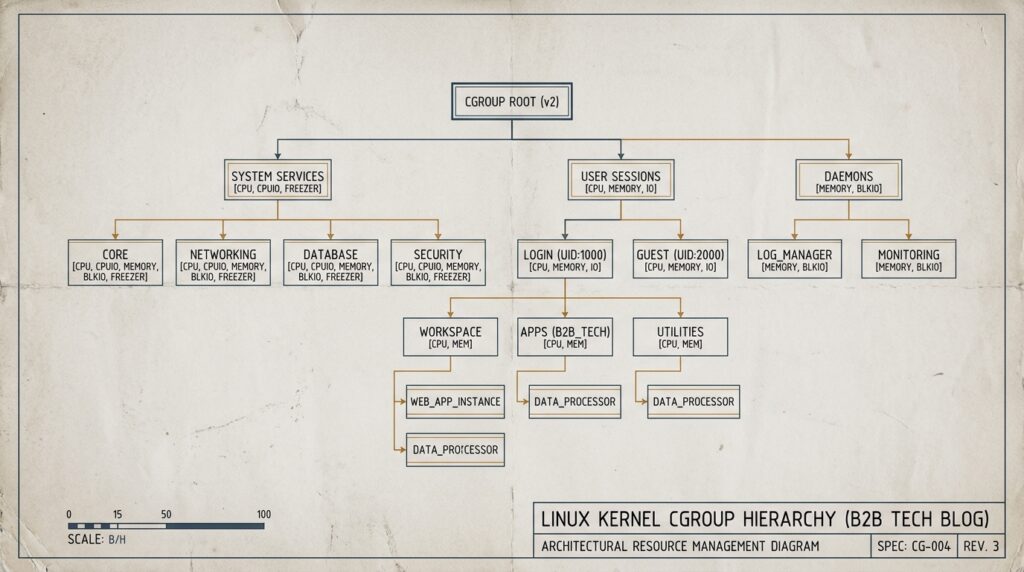
cgroup v2 reemplazó la jerarquía fragmentada con un único árbol unificado. Un proceso pertenece exactamente a un cgroup. Todos los controladores (CPU, memoria, IO) están habilitados en ese único nodo. El kernel siempre sabe qué cgroup es responsable de una acción sobre un recurso, lo que cierra la brecha de contabilidad que hacía poco fiables los límites de I/O en v1.
En cgroup v1, el controlador blkio no sabía a qué cgroup de memoria pertenecía un proceso. Cuando el kernel enviaba una página a disco, la I/O se cargaba al cgroup raíz, eludiendo por completo los límites del contenedor. cgroup v2 cierra esa brecha imponiendo una jerarquía única donde todos los controladores comparten la misma membresía de procesos.
Cambios de interfaz que romperán tus herramientas
El cambio arquitectónico conlleva eliminaciones concretas de interfaces que afectan tanto a los runtimes como a las herramientas de observabilidad. Los equipos que han construido contabilidad personalizada de recursos o herramientas de políticas de red sobre interfaces de cgroup v1 necesitan auditar específicamente esas integraciones.
- El subsistema
cpuacctdesaparece en v2; la contabilidad de CPU la gestiona ahora directamente el subsistemacpu. - El subsistema
freezerse elimina; el equivalente escgroup.freezeen la interfaz general de v2. - Las interfaces
net_clsynet_priono existen en v2; el filtrado y la configuración del tráfico de red se trasladan a eBPF. - En v2, los procesos solo pueden adjuntarse a cgroups hoja. Un cgroup que tiene cgroups hijos no puede contener procesos directamente, lo que elimina la ambigua membresía de procesos padre-hijo de v1.
En el lado positivo, v2 incorpora capacidades que v1 no podía soportar de forma limpia: Pressure Stall Information para CPU, memoria e IO; contabilidad unificada para memoria de red y memoria de kernel junto a memoria anónima; y la funcionalidad MemoryQoS, que mejora las garantías de calidad de servicio de memoria usando directamente las primitivas de v2.
El calendario de eliminación, versión por versión
La deprecación siguió un enfoque gradual y deliberado a lo largo de varias versiones. Entender la secuencia es importante porque los equipos con ciclos de soporte extendido o cadencias de actualización lentas pueden estar más cerca del límite definitivo de lo que creen.
- Kubernetes 1.25: el soporte de cgroup v2 alcanza GA. A partir de aquí fue seguro ejecutar v2 en producción.
- Kubernetes 1.31: cgroup v1 entra en modo de mantenimiento bajo KEP-4569. Sin nuevas funcionalidades; la funcionalidad existente queda congelada.
- Kubernetes 1.35: el flag
failCgroupV1del kubelet pasa a sertruepor defecto. El kubelet falla al arrancar si no detecta cgroup v2 en el nodo. Esto corresponde a KEP-5573 alcanzando beta. - Kubernetes 1.36 (publicado el 22 de abril de 2026): soporte de cgroup v1 eliminado por completo. Los nodos que aún estén en modo v1 no pueden ejecutar esta versión en absoluto.
- Kubernetes 1.38: fecha más temprana para la eliminación del código de cgroup v1 del propio código fuente, según KEP-5573, para respetar la política de deprecación de Kubernetes.
La implicación práctica del cambio en 1.35 es que los equipos que aún no habían migrado recibieron una señal de aviso: actualizar a 1.35 hace que el kubelet indique explícitamente que la configuración del nodo es incompatible. Actualizar a 1.36 sin corregirlo hace que el nodo simplemente no arranque.
Qué requiere realmente una migración a nivel de nodo
La migración no es un cambio de configuración de Kubernetes. Es una operación a nivel de host que debe completarse antes de la actualización del clúster, y tiene tres componentes que deben ser coherentes entre sí.
Parámetro de arranque del kernel: el nodo debe arrancar con la jerarquía unificada de cgroup habilitada. En la mayoría de distribuciones esto implica añadir systemd.unified_cgroup_hierarchy=1 a la línea de comandos del kernel en GRUB y reiniciar. En distribuciones que ya incluyen cgroup v2 como predeterminado (Fedora reciente, RHEL 9, Ubuntu 22.04 y posteriores, Debian 11 y posteriores) esto ya está configurado. En imágenes LTS antiguas, no.
Configuración del runtime de contenedores: containerd debe configurarse para usar el driver de cgroup systemd. En /etc/containerd/config.toml, la sección relevante es [plugins."io.containerd.grpc.v1.cri".containerd.runtimes.runc.options] con SystemdCgroup = true. Las configuraciones basadas en Docker requieren el cambio equivalente en la configuración del daemon de Docker.
Configuración del kubelet: el kubelet también debe configurarse para usar el driver de cgroup systemd. En el objeto KubeletConfiguration, cgroupDriver: systemd. El kubelet y el runtime de contenedores deben coincidir en el driver; una discrepancia provoca fallos en la creación de pods que son difíciles de diagnosticar a posteriori.
Tras el reinicio, verifica la jerarquía activa con stat -fc %T /sys/fs/cgroup/. La salida debe ser cgroup2fs. Si devuelve tmpfs, el nodo sigue en v1.
Dónde importa realmente el control de la infraestructura
Esta migración es sencilla en infraestructura donde controlas el host. En los servicios gestionados de Kubernetes de los grandes proveedores cloud, la imagen del nodo, la versión del kernel, la configuración de cgroup y los parámetros de arranque están abstraídos. Actualizas la versión del plano de control y confías en que las imágenes del pool de nodos gestionado ya sean compatibles. Cuando no lo son, la ruta de remediación pasa por la cola de soporte del proveedor en lugar de tus propias herramientas.
En los entornos de bare-metal y VDS de DIVERSITY, nuestros clientes tienen acceso directo a la configuración del kernel y de cgroup a nivel de nodo, que es exactamente la superficie de control que requiere esta migración. Nuestro equipo de IT Consulting ha estado trabajando en auditorías de migración a cgroup v2 con clientes que ejecutan cargas de trabajo contenerizadas en nuestra infraestructura, validando versiones del kernel, configuraciones de containerd y la alineación del driver del kubelet antes del corte a 1.36.
La lista de verificación de auditoría para cualquier equipo que ejecute Kubernetes hoy debe cubrir: la versión del kernel en cada tipo de nodo (v2 requiere Linux 4.15 como mínimo, con soporte completo de funcionalidades desde 5.8 en adelante); el valor predeterminado de la distribución para la jerarquía de cgroup; la versión de containerd o CRI-O y su configuración del driver de cgroup; cualquier herramienta personalizada de contabilidad de recursos construida sobre interfaces de v1; y cualquier DaemonSet o agente a nivel de nodo que interactúe directamente con el sistema de archivos cgroup.
Cómo planificar tu actualización
Si ejecutas Kubernetes 1.31 a 1.34, estás en una versión que aún soporta v1 pero lo tiene congelado. Tienes tiempo para migrar los nodos antes de actualizar, que es el orden correcto de operaciones. Si ya estás en 1.35, el flag failCgroupV1 es tu señal: cualquier nodo que no haya arrancado tras la actualización te indica exactamente qué hosts necesitan remediación. No suprimas el flag para restaurar la disponibilidad; corrige la configuración del nodo y deja que el kubelet la valide correctamente.
Los equipos en 1.36 o que planeen moverse allí no tienen alternativa. El código ha desaparecido. La migración es un prerrequisito, no una tarea posterior.
cgroup v2 no es nuevo. Lleva varios años siendo el predeterminado en las principales distribuciones Linux, y Kubernetes lo ha soportado en GA desde 1.25. El calendario de deprecación fue largo y bien señalizado. Lo que hace la versión 1.36 es eliminar la opción de aplazarlo, y eso merece tratarse como la señal de aviso que fue diseñada para ser.